title: "Grok 4.5 正式登場!1.5T 參數、比 GPT-5.5 便宜 60%,xAI 如何改寫 AI 戰場格局?"
date: 2026-07-09
labels: tech, AI, Grok, xAI, LLM, benchmark, coding
一句話結論: Grok 4.5 用 GPT-5.5 四成的價格,做到九成的實力——AI 戰場格局正在被改寫。
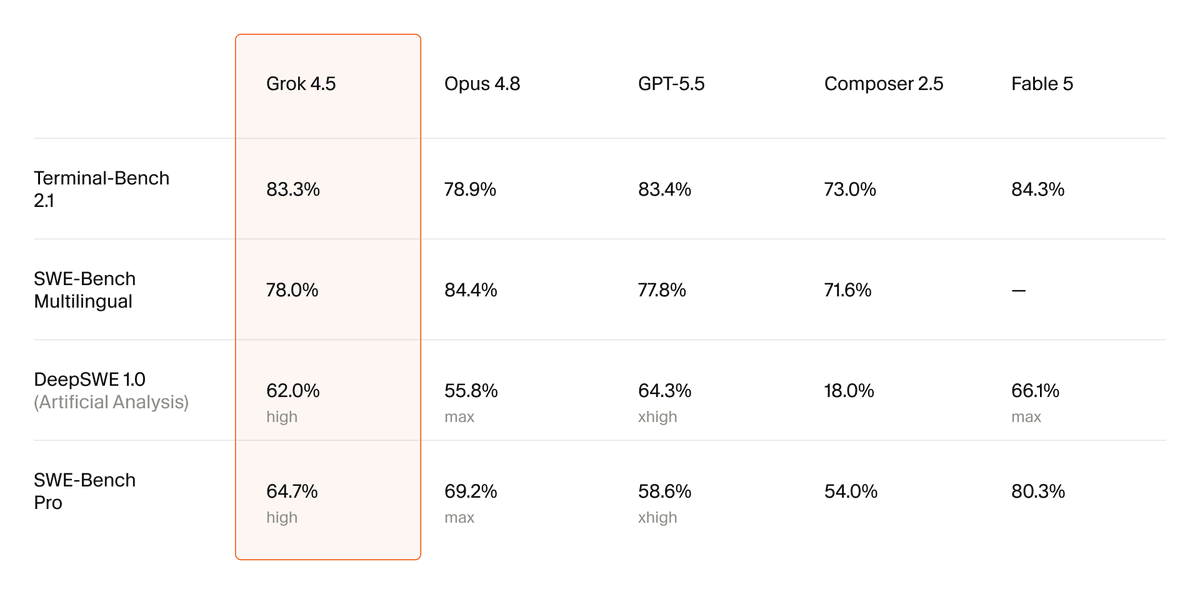
2026 年 7 月 8 日,xAI(SpaceXAI)正式發布 Grok 4.5——這是該公司首個專門為編碼與 AI 代理(Agent)訓練的大型語言模型。Elon Musk 在 X 平台發文後短短數小時內獲得超過 4.7 萬個讚、520 萬次觀看,話題迅速引爆科技圈。
但這次 Grok 4.5 的真正殺手鐧,不是 benchmark 分數有多高,而是同等級智慧下,成本只有競爭對手的一小部分。根據 Artificial Analysis 獨立評測,Grok 4.5 在 Intelligence Index 排名第四(僅次於 Fable 5、GPT-5.5 和 Opus 4.8),但每任務成本僅 $0.31——是 Opus 4.8 的五分之一、GPT-5.5 的三分之一。
這篇文章將深入拆解 Grok 4.5 的技術規格、benchmark 數據的真實意義,以及它對開發者和投資者意味著什麼。
Grok 4.5 是什麼?為什麼重要?
Grok 4.5 是 xAI(SpaceXAI)推出的最新旗艦模型,基於 1.5 兆參數的 V9 架構(是前代 Grok 4.3 的三倍大),並與 Cursor(知名的 AI 編碼助手)聯合訓練。這是 xAI 第一次明確將模型定位為「編碼與 Agent」專用,而非通用對話模型。
關鍵規格一覽:- 參數規模: 1.5 兆(1.5T),V9 架構
- 上下文窗口: 500K tokens(較 Grok 4.3 的 1M 有所縮減,但保留了可配置推理和視覺輸入)
- 定價: $2 / 百萬輸入 tokens,$6 / 百萬輸出 tokens
- 推理速度: 約 80 tokens/秒
- 每任務成本: $0.31(Intelligence Index)、$2.49(Coding Agent Index)
- Token 效率: 每任務使用的 tokens 比競爭對手少 50% 以上
- 可用平台: SpaceXAI API、Grok Build、Cursor
Elon Musk 在 X 上表示:「我們內部評估認為 Grok 4.5 大致相當於 Opus 4.7,但速度更快。能力、速度和成本的結合才是它的競爭力所在。」
Benchmark 分數到底怎麼看?白話解讀三大評測
很多 AI 新聞只列數字不解釋,這裡用白話幫你拆解 Grok 4.5 在三大評測中的表現:
1. Intelligence Index(綜合智慧排名)
根據 Artificial Analysis 的 Intelligence Index,Grok 4.5 得分 54 分,排名第四:
- 第 1 名: Fable 5(Anthropic 最新)
- 第 2 名: GPT-5.5(OpenAI 最新)
- 第 3 名: Opus 4.8(Anthropic)
- 第 4 名: Grok 4.5(xAI)
- 第 5 名: GLM-5.2(智譜 AI)
Grok 4.5 比前代 Grok 4.3 提升了 16 分,這是一個顯著的跳躍。更關鍵的是,它超越了所有開源模型,也超越了 Google 的 Gemini 系列。
白話說: Grok 4.5 雖然不是第一名,但已經進入了「前四強」的第一梯隊。距離頂尖(Fable 5)的差距約 16%,但成本差距卻高達 10 倍。2. CursorBench(編碼能力評測)
CursorBench 專門測試 AI 模型在實際編程場景中的表現:
- Fable 5 Max: 70.5%($17.32/任務)
- Grok 4.5 High: 66.7%($1.51/任務)
- Opus 4.8 Max: 低於 66.7%(更高成本)
Grok 4.5 的編碼分數排名第三,僅次於 Fable 5 Max,但成本只有 Fable 5 的十分之一。
白話說: 如果你是開發者,Grok 4.5 的編碼能力已經夠用了——95% 的場景下你感受不到和頂尖模型的差距,但你的 API 賬單會少很多。3. Coding Agent Index(AI 代理編碼評測)
這個評測模擬 AI 代理自主完成軟體工程任務的能力(DeepSWE、Terminal-Bench v2、SWE-Atlas QnA):
- Fable 5(Claude Code): 分數最高,但每任務成本 $11.80,使用 7.2M tokens
- GPT-5.5(Codex): 分數與 Grok 4.5 持平,每任務成本 $5.07,使用 6.2M tokens
- Grok 4.5(Grok Build): 分數 76 分,每任務成本 $2.49,僅使用 1.9M tokens
成本戰:Grok 4.5 如何用價格優勢颠覆市場?
這張圖清楚展示了 Grok 4.5 在成本-性能前沿(Pareto frontier)上的位置:
 定價對比(每百萬 tokens):
- Grok 4.5: 輸入 $2 / 輸出 $6
- Claude Opus 4.8: 輸入 $5 / 輸出 $25(Grok 的 4-5 倍貴)
- GPT-5.5(Sol): 輸入 $5 / 輸出 $30(Grok 的 5 倍貴)
- GPT-5.5(Luna): 輸入 $1 / 輸出 $6(最便宜版,但智慧等級較低)
更驚人的是實際使用成本:
- Grok 4.5 每任務僅使用約 1.4 萬輸出 tokens,比 Opus 4.8 少 60% 以上
- 這不只是「單價便宜」,而是「用的量也少」——雙重省錢
CursorBench 完整排名:Grok 4.5 的真實定位
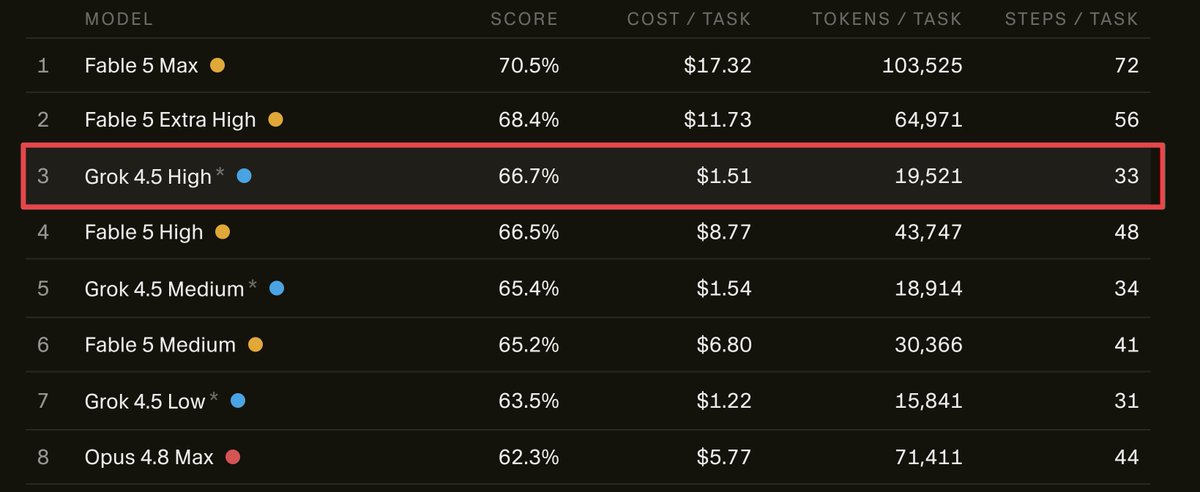 CursorBench 完整排名(2026-07-08):
- #1 Fable 5 Max: 70.5% — $17.32/任務
- #2 Fable 5 High: 低於 70.5% — 更低成本
- #3 Grok 4.5 High: 66.7% — $1.51/任務
- #4 Opus 4.8 Max: 低於 66.7% — 更高成本
Grok 4.5 在編碼能力上已經超越了 Opus 4.8,並且以不到十分之一的成本達成。這讓它成為目前「性價比最高」的前沿編碼模型。
Grok 4.5 的短板在哪裡?
公平起見,Grok 4.5 並非完美。根據 Artificial Analysis 的 AA-Omniscience Index(知識準確性評測):
- 準確率: 從 Grok 4.3 的 35% 提升到 52%(進步明顯)
- 幻覺率: 從 25% 上升到 54%(明顯退步)
這是大型模型的常見悖論:模型越大、知道的越多,但同時也更「自信」——包括對錯誤的資訊自信。Grok 4.5 在知識準確性上仍落後頂尖模型,這在需要高精確度的場景(如醫療、法律)中可能成為限制。
此外:- 上下文窗口從 1M 縮減到 500K(犧牲了一些長文處理能力)
- 目前尚未在歐盟上線(預計 7 月中旬)
- 幻覺率偏高意味著在生產環境中仍需人工審核
對比總結:Grok 4.5 vs GPT-5.5 vs Opus 4.8
Intelligence Index 排名:- Grok 4.5:第 4 名(54 分)
- GPT-5.5:第 2 名(高於 54 分)
- Opus 4.8:第 3 名(高於 54 分)
- Grok 4.5:$0.31
- GPT-5.5:估算 $0.5-1.0
- Opus 4.8:估算 $1.0-2.0
- Grok 4.5:66.7%($1.51/任務)
- GPT-5.5:與 Grok 4.5 持平($5.07/任務)
- Opus 4.8:低於 66.7%
- Grok 4.5:每任務約 1.4 萬輸出 tokens
- GPT-5.5:約 3.5 萬輸出 tokens
- Opus 4.8:約 3.5 萬輸出 tokens
開發者和投資者該怎麼看?
對開發者:- 如果你的 AI 應用以編碼為主,Grok 4.5 現在是最佳性價比選擇
- 可以在 Cursor 中直接使用,整合成本為零
- 適合用於 AI 代理工作流(agentic workflows),在代理任務上表現優異
- 注意幻覺率問題,關鍵場景需搭配人工審核
- xAI 通過 Grok 4.5 證明了「低成本前沿」策略的可行性
- 這種「夠好 + 便宜很多」的定位可能重塑 AI 模型市場的定價結構
- 關注 xAI 後續是否能保持「每月發布新模型」的節奏
- Microsoft Office 插件(Word、PowerPoint、Excel)正在推出,企業市場潛力大
結語
Grok 4.5 的發布標誌著 AI 競爭進入了一個新階段:不再只是比誰更聰明,而是比誰更划算。當 GPT-5.5 和 Opus 4.8 還在爭奪「最強」的頭銜時,xAI 用 Grok 4.5 證明了一個更務實的商業邏輯:大多數用戶不需要最強的模型,他們需要的是足夠強、但便宜很多的模型。
這場「智慧戰」正在變成「價格戰」——而開發者和企業將是最大的受益者。
常見問題 (FAQ)
Q1:Grok 4.5 和 GPT-5.5 哪個比較強?
從 Intelligence Index 分數來看,GPT-5.5 排名第二,Grok 4.5 排名第四,GPT-5.5 在純智慧層面略勝一籌。但在編碼能力(CursorBench)上,兩者幾乎持平。最重要的差異在成本:Grok 4.5 的每任務成本約為 GPT-5.5 的三分之一到五分之一。
Q2:Grok 4.5 的 1.5T 參數代表什麼?
1.5 兆(1.5 trillion)參數是指模型的神經網路規模。作為對比,Grok 4.3 約為 5000 億參數,Grok 4.5 是其三倍。更大的參數量通常意味著更強的學習能力,但也需要更多計算資源來訓練和推理。
Q3:Grok 4.5 的 token 效率為什麼這麼高?
根據 Artificial Analysis 的分析,Grok 4.5 每任務使用的輸出 tokens 比 Opus 4.8 少 60% 以上。這來自兩個方面:一是模型本身更高效(用更少的 tokens 表達同等資訊),二是 Cursor 的聯合訓練優化了編碼場景的 token 使用。
Q4:Grok 4.5 可以免費使用嗎?
Grok 4.5 目前可通過 SpaceXAI API 使用,定價為 $2/百萬輸入 tokens、$6/百萬輸出 tokens。X Premium 用戶可能享有一定額度的免費使用。此外,Grok Build 和 Cursor 也已整合 Grok 4.5。
Q5:Grok 4.5 的 500K 上下文窗口夠用嗎?
500K tokens 約等於 37.5 萬個英文單詞或 25 萬個中文字,足以處理绝大多数長文分析、大型程式碼庫和多輪對話場景。相比 Grok 4.3 的 1M 窗口有所縮減,但實際使用中 500K 已綽綽有餘。
Q6:Grok 4.5 的幻覺率為什麼偏高?
根據 Artificial Analysis 的 AA-Omniscience Index,Grok 4.5 的幻覺率從前代的 25% 上升到 54%。這是大型模型的常見現象:模型越大、訓練數據越豐富,對自身知識的「自信度」也越高,包括對錯誤資訊的自信。這不是 Grok 獨有的問題,而是目前所有前沿模型都面臨的挑戰。
Q7:Grok 4.5 什麼時候在歐盟可用?
根據目前資訊,Grok 4.5 預計在 2026 年 7 月中旬登陸歐盟市場。xAI 需要先通過歐盟《人工智慧法案》(AI Act)的合審查。
Q8:Cursor 為什麼要和 xAI 聯合訓練 Grok 4.5?
Cursor 是目前最流行的 AI 編碼助手之一,擁有大量真實的程式碼互動數據。通過將這些數據用於 Grok 4.5 的補充訓練,xAI 獲得了寶貴的「真實編碼場景」數據,而 Cursor 則獲得了深度整合的專屬模型。這是一種雙贏的策略合作。
資料來源:xAI 官方公告、Artificial Analysis 獨立評測、Cursor 官方推文、TechCrunch 報導、Wikipedia Grok 條目 撰文日期:2026 年 7 月 9 日
留言
張貼留言