跳到主要內容

以色列「適應性重置」突破:一隻蜜蜂如何啟發 AI 訓練加速革命

特拉維夫大學團隊提出適應性重置方法,可能加速 AI 訓練與分子模擬

你有沒有想過,一隻蜜蜂尋找花朵的過程,竟然能為人工智慧的訓練效率帶來革命性的突破?

2026 年 7 月,以色列特拉維夫大學(Tel Aviv University)化學學院的研究團隊在頂級期刊《Nature Communications》發表了一篇重磅論文,提出名為「適應性重置」(Adaptive Resetting)的全新通用方法。這個看似簡單的概念,正在改變我們對隨機搜尋過程的理解,並且已經開始在蛋白質折疊模擬和神經網路訓練中展現驚人的加速效果。

什麼是「隨機重置」?從蜜蜂找花說起

先來聽一個簡單的故事。

想像一隻蜜蜂離開蜂巢去尋找花朵。蜂巢是起點,花朵是目標。由於花朵的位置事先未知,蜜蜂每次飛出去都會走不同的路線,到達花朵所需的時間因此是隨機的。

現在想像,蜜蜂會不時「重置」自己——飛回蜂巢重新出發。這種機制在物理學中叫做隨機重置(Stochastic Resetting)。

蛋白質折疊示意圖:分子結構從展開到正確摺疊的過程

科學家大約在十年前就發現,適度的「重置」可以加速搜尋過程——因為如果蜜蜂飛到一個完全錯誤的方向,與其繼續浪費時間,不如回巢重新開始。但問題是,過去所有的理論都假設重置是固定的、與狀態無關的——也就是說,蜜蜂不論離花朵多近或多遠,回巢的機率都一樣。

這顯然不合理。如果蜜蜂已經聞到花香了,它為什麼要回家?

突破:讓重置變得「聰明」

特拉維夫大學的博士生 Tommer Keidar 和 Ofir Blumer,在 Prof. Barak Hirshberg 和 Prof. Shlomi Reuveni 的指導下,正是解決了這個問題。

他們提出的適應性重置框架,核心創新在於:

  • 重置率會根據系統狀態即時調整:離目標近時降低重置率(不要中斷),離目標遠時提高重置率(趕快重來)
  • 只需分析「無重置」的軌跡,就能預測「有重置」的行為:透過一種「重新加權」(Reweighting)方法,避免了耗時的大量模擬
  • 神經網路可以自動學習最佳重置策略:將重置概率表示為神經網路的輸出,用標準的梯度下降優化

簡單來說,過去的做法相當於「蜜蜂不管三七二十一就回家」,而新方法則是「蜜蜂學會了判斷什麼時候該回家、什麼時候該堅持」。

實驗驗證:蛋白質折疊加速

這不只是理論突破。研究團隊在蛋白質折疊模擬中驗證了方法的實際效果。

他們選用了迷你蛋白質 chignolin(含 5889 個原子的分子動力學模擬系統)作為測試對象。這個蛋白質有三個穩定狀態:未折疊態、錯誤折疊態和正確折疊態(天然態)。模擬的目標是讓蛋白質從未折疊或錯誤折疊的狀態,找到正確的折疊路徑。

適應性重置方法的示意圖:蜜蜂根據環境資訊調整回家的頻率

結果令人印象深刻:

  • 神經網路在訓練初期(約 25 個 epoch)就找到了與先前研究相當的固定重置策略
  • 但隨著訓練深入(約 100 個 epoch),網路發現了更精妙的狀態依賴重置策略,進一步提升了加速比
  • 對於從未折疊態出發的模擬,適應性重置帶來了顯著的加速,而先前的固定重置方法對此場景幾乎無效

論文中展示的訓練曲線清楚表明,神經網路學到的重置策略不是隨機的——它們具有明確的物理意義:在蛋白質接近正確折疊態時降低重置率,讓模擬有更多時間探索低能量區域。

為什麼這很重要?

這項研究的影響力遠不止於蛋白質折疊。適應性重置框架的通用性,讓它在多個領域都有潛在應用:

搜尋演算法優化
  • 搜尋代理(無論是動物、演算法還是機器人)可以根據環境線索動態調整重置策略
  • 對於 Las Vegas 演算法、搜尋引擎排序等問題,可能帶來效率提升
分子動力學模擬
  • 蛋白質折疊、晶體成核等需要長時間尺度模擬的過程,可以透過適應性重置顯著加速
  • 與 Metadynamics 等增強取樣方法結合,效果更佳
神經網路訓練
  • 訓練過程中的「重置」(如重新初始化部分權重)可以根據訓練狀態動態調整
  • 對於大型語言模型的訓練效率,可能有深遠影響
化學反應模擬
  • 酶催化反應中的底物脫落和結合過程,本身就有「重置」的特性
  • 適應性重置可以更準確地模擬這些生物化學過程

從理論到工具:開源代碼已釋出

值得注意的是,研究團隊已經將完整的 Python 實現代碼開源到 GitHub:

https://github.com/OfirBlumer/adaptiveResetting

代碼包含:

  • 估計平均首達時間(MFPT)的腳本
  • 首達時間分佈的計算工具
  • 非平衡穩態(NESS)的預測方法
  • 神經網路訓練腳本,用於優化重置策略

這意味著任何研究者都可以立即使用這個框架來加速自己的模擬工作。

個人觀點:這可能是被低估的突破

坦白說,我第一眼看到這篇論文時,覺得「蜜蜂找花」的故事太童話了。但深入閱讀後才發現,這個框架的數學基礎非常紮實,而神經網路自動學習最佳重置策略的思路,更是將傳統物理學與現代機器學習巧妙結合的典範。

更讓我印象深刻的是,這個方法的計算成本極低——它不需要運行大量帶重置的模擬,只需要分析「無重置」的軌跡就能預測一切。在當今 AI 訓練成本高昂的時代,這種「用更少的計算做更多的事」的方法論,可能比任何單一演算法優化都更有價值。
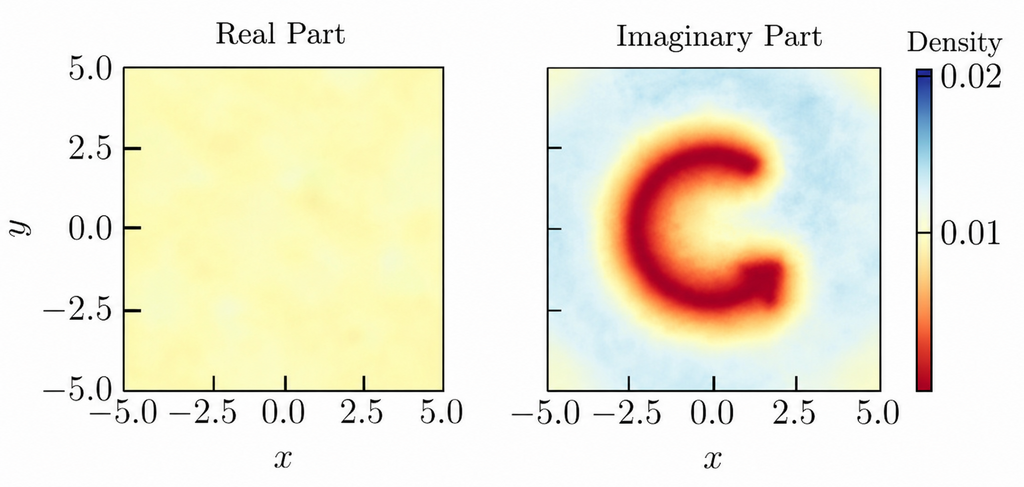
研究團隊的適應性重置概念圖

當然,從學術論文到實際工程應用之間,還有很長的路要走。蛋白質折疊模擬的成功,是否能推廣到更大規模的分子系統?神經網路學到的重置策略,是否能遷移到完全不同的問題上?這些問題都需要後續研究來回答。

但有一點是確定的:當一隻小小的蜜蜂學會了「什麼時候該回家」,它可能正在為下一場 AI 革命播下種子。


論文資訊
  • 標題:Adaptive resetting for informed search strategies and the design of non-equilibrium steady-states
  • 期刊:Nature Communications
  • DOI:https://www.nature.com/articles/s41467-025-62398-2
  • 作者:Tommer D. Keidar, Ofir Blumer, Barak Hirshberg, Shlomi Reuveni
  • 機構:特拉維夫大學化學學院
  • 開源代碼:https://github.com/OfirBlumer/adaptiveResetting

#適應性重置 #AI訓練加速 #蛋白質折疊 #分子模擬 #NatureCommunications #特拉維夫大學 #隨機搜尋 #神經網路優化 #計算化學 #統計物理學

留言

這個網誌中的熱門文章

Why Is NVIDIA Spending Billions to Buy Up America's "Dark Fiber"?

One-line conclusion: NVIDIA is reportedly spending $5–10 billion to acquire long-haul "dark fiber" networks across the United States, signaling that the AI infrastructure race is shifting from raw compute power to the networks that connect it. NVIDIA is reportedly acquiring long-haul "dark fiber" networks across the United States, with total capacity estimated at 7.6 Pbps and a price tag between $5 billion and $10 billion. The news sent optical communications stocks surging globally: Taiwan's optical module makers jumped on July 22, and three more hit the daily limit on July 23. Many now read this as the moment the AI arms race moved from "who has more GPUs" to "who owns the network." What Is Dark Fiber, and Why Buy Instead of Lease? Dark fiber refers to fiber-optic cable that has already been laid but has no transmission equipment installed and carries no optical signal . The fiber cores sit "dark" and dormant, waiting to...

What Is x402? How HTTP 402 Is Making Peer-to-Peer Web Payments a Reality

One-line conclusion: x402 is an open payment standard launched by Coinbase in 2025 that resurrects the long-dormant HTTP 402 "Payment Required" status code, enabling websites to complete peer-to-peer cryptocurrency payments directly within the HTTP request-response cycle — no accounts, no intermediaries, no payment gateways required. HTTP 402: The Status Code That Waited 25 Years for Its Moment If you know your HTTP status codes, you're probably familiar with 200 (OK), 404 (Not Found), and 500 (Server Error). But did you know there's a 402 status code? Back in the 1990s, the HTTP/1.0 specification reserved 402 Payment Required for digital cash and micropayment scenarios — a way for servers to tell clients: "Pay up before you access this resource." For 25 years, it remained virtually unused. The reason? Infrastructure wasn't ready. Payments were slow, expensive, and required accounts, sessions, and intermediaries. Now, that forgotten status c...

Grok 45

title: "Grok 4.5 正式登場!1.5T 參數、比 GPT-5.5 便宜 60%,xAI 如何改寫 AI 戰場格局?" date: 2026-07-09 labels: tech, AI, Grok, xAI, LLM, benchmark, coding 一句話結論: Grok 4.5 用 GPT-5.5 四成的價格,做到九成的實力——AI 戰場格局正在被改寫。 2026 年 7 月 8 日,xAI(SpaceXAI)正式發布 Grok 4.5——這是該公司首個專門為 編碼與 AI 代理(Agent) 訓練的大型語言模型。Elon Musk 在 X 平台發文後短短數小時內獲得超過 4.7 萬個讚、520 萬次觀看,話題迅速引爆科技圈。 但這次 Grok 4.5 的真正殺手鐧,不是 benchmark 分數有多高,而是 同等級智慧下,成本只有競爭對手的一小部分 。根據 Artificial Analysis 獨立評測,Grok 4.5 在 Intelligence Index 排名第四(僅次於 Fable 5、GPT-5.5 和 Opus 4.8),但每任務成本僅 $0.31——是 Opus 4.8 的五分之一、GPT-5.5 的三分之一。 這篇文章將深入拆解 Grok 4.5 的技術規格、benchmark 數據的真實意義,以及它對開發者和投資者意味著什麼。 Grok 4.5 是什麼?為什麼重要? Grok 4.5 是 xAI(SpaceXAI)推出的最新旗艦模型,基於 1.5 兆參數的 V9 架構 (是前代 Grok 4.3 的三倍大),並與 Cursor(知名的 AI 編碼助手)聯合訓練。這是 xAI 第一次明確將模型定位為 「編碼與 Agent」專用 ,而非通用對話模型。 關鍵規格一覽: 參數規模: 1.5 兆(1.5T),V9 架構 上下文窗口: 500K tokens(較 Grok 4.3 的 1M 有所縮減,但保留了可配置推理和視覺輸入) 定價: $2 / 百萬輸入 tokens,$6 / 百萬輸出 tokens 推理速度: 約 80 tokens/秒 每任務成本: $0.31(Intelligence Index)、$2.49(Coding Agent I...